El 57 % del tráfico en la web ya no es humano, y el WAF no sabe qué hacer con eso
Durante el análisis de logs de acceso de un sistema de recuperación de información documental desplegado sobre AWS, se identificó un patrón de saturación que no correspondía a ningún vector de ataque conocido. El servidor registraba alarmas de CPU en CloudWatch, los usuarios reportaban lentitud y, sin embargo, la revisión del Web ACL de WAF no mostraba bloqueos relevantes, patrones de ataque ni IPs marcadas como maliciosas. El tráfico era, desde todos los ángulos de la seguridad convencional, completamente válid[Dec 2025 12:35:06] GET /search
?idx=subject&q=10070
&filter=topic:Science+Communication
&filter=topic:Science+Communication
&filter=available&sort_by=relevance&count=20
&filter=series:National+Reading+Program
HTTP/1.1 200 12698
“meta-webindexer/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)”
[Dec 2025 12:35:08] GET /search
?idx=subject&q=16924
&filter=branch:BRANCH-02&filter=collection:Adult
&sort_by=relevance&count=20
HTTP/1.1 200 12675
“meta-webindexer/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)”
[Dec 2025 12:35:10] GET /search
?type=catalog&q=42707&idx=subject,phrase
HTTP/1.1 302 411
“meta-webindexer/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)
En treinta y cuatro segundos, el agente meta-webindexer ejecutó más de 25 búsquedas con parámetros únicos desde múltiples rangos de IP. En ese mismo intervalo, un operador humano catalogaba registros desde Chrome en la misma instancia, sin ningún mecanismo de diferenciación de prioridad entre ambos flujos.
Este artículo examina ese patrón: un agente legítimo que genera carga computacional equivalente a un ataque volumétrico, que los sistemas de defensa convencionales en AWS no pueden mitigar sin incurrir en un costo de negocio, y para el que el ecosistema recién comienza a construir respuestas.
1. El contexto: los números ya no son abstractos
Los logs descritos no son una anomalía. Son consistentes con una tendencia documentada por múltiples fuentes de infraestructura.
En 2024, el tráfico automatizado superó por primera vez en una década el 51% del tráfico web global, según el Bad Bot Report 2025 de Imperva . En 2025, ese porcentaje subió al 53% . En junio de 2026, Cloudflare Radar registró 57.4% de tráfico automatizado en su red, un cruce que el CEO de la compañía describió como ocurrido “años antes de lo esperado” .
Dentro de ese volumen, los crawlers de IA muestran el crecimiento más acelerado. Según datos de su propia red (que cubre aproximadamente una quinta parte de los sitios de internet), Cloudflare reportó que GPTBot aumentó un 305% su actividad entre mayo de 2024 y mayo de 2025 . Meta-WebIndexer generó 9,100 millones de solicitudes en Q2 2026, más de la mitad de los 17,700 millones de AI agent requests totales observados en la red de DataDome durante ese trimestre. DataDome es una firma de detección de bots con interés comercial en visibilizar el problema, lo que debe considerarse al interpretar la cifra . PromptWatch reporta que Meta-WebIndexer pasó de representar el 2.2% al 37.8% del tráfico de AI crawlers en su panel en menos de treinta días. Dado lo extraordinario del incremento, y dado que PromptWatch no publica metodología ni tamaño de muestra, el dato se presenta como indicador de tendencia, no como medición verificable .
El administrador de kernel.org publicó en agosto de 2026 un análisis técnico de su propia infraestructura: de 90 CPUs distribuidos en cinco nodos, entre 14 y 16 se dedicaban de forma permanente a servir páginas a AI scrapers, más que todos los git clones y la navegación legítima combinados . Se trata de un caso único, pero la fuente es el administrador de un repositorio de referencia global y el relato es técnicamente verificable.
La consistencia de dirección entre fuentes de distintos niveles de rigor sugiere que el fenómeno es real, aunque la magnitud exacta varíe según quién lo mida.
2. Por qué esto no es un DDoS, y por qué esa diferencia es el problema
La confusión entre este patrón y un ataque de denegación de servicio distribuido (DDoS) es frecuente porque los síntomas observables a nivel de métricas son los mismos: CPU elevada, latencia alta, instancias bajo presión. La causa estructural, sin embargo, es radicalmente diferente.
Tabla 1. Comparación entre ataques DDoS volumétricos y el patrón descrito
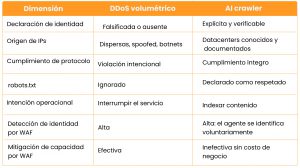
La distinción central está en la última fila. AWS WAF Bot Control identifica correctamente a meta-webindexer mediante análisis estático del User-Agent. Lo clasifica como bot de categoría social media o content fetcher y aplica los labels correspondientes. El problema no es la detección. El problema es que las acciones disponibles tras esa identificación son bloquear o permitir, y ninguna de las dos resuelve la tensión de capacidad:
-
- Bloquear elimina la presencia del sistema en Meta AI Search. Para sistemas cuyo modelo de valor depende de ser descubiertos, ese costo puede superar al de infraestructura.
- Permitir implica que cada solicitud consume los mismos recursos computacionales que una consulta de usuario real, sin ningún mecanismo de diferenciación de prioridad.
No existe en el modelo de WAF una acción que redirija el tráfico del bot hacia una capa de caché de forma automática e integrada con CloudFront. WAF sí permite configurar respuestas personalizadas en acciones Block: se puede devolver un 429 con Retry-After para señalar throttling, o un 302 con header Location apuntando a otra URL. Sin embargo, estas respuestas las recibe el bot cliente, no CloudFront: WAF termina la conexión y le indica al bot que vaya a otra URL, pero no enruta la solicitud internamente hacia CloudFront ni hacia un origen alternativo. Para que el bot sea servido desde caché sin que tenga que hacer una segunda solicitud, la integración con CloudFront requiere lógica adicional fuera de WAF.
Adicionalmente, la indiferenciación semántica a nivel de procesamiento produce una categoría de problema que los marcos convencionales de gestión de amenazas no contemplan, precisamente porque el agente no actúa como amenaza.
3. Por qué el escalamiento reactivo amplifica el problema
La respuesta operacional más común ante saturación en AWS es el escalamiento. El auto-scaling de EC2 responde al incremento de métricas capturadas por CloudWatch: CPU, tasa de solicitudes, latencia. Cuando la carga sube, se levantan instancias adicionales.
El problema es que el auto-scaling no distingue la fuente de esa carga. Cuando un agente de indexación genera la mayor parte del tráfico, el escalamiento asigna capacidad adicional a servirlo. El tráfico de usuarios reales sigue compitiendo con el bot por los mismos recursos, ahora en más instancias. El costo operacional aumenta sin que la experiencia del usuario mejore.
Existe una razón estructural por la que esto ocurre: los labels aplicados por WAF a las solicitudes no se propagan como señales a CloudWatch ni a las políticas de auto-scaling. WAF puede etiquetar una solicitud como awswaf:managed:aws:bot-control:bot:category:social_media, pero esa etiqueta no existe para el sistema de escalamiento. CloudWatch observa CPU alta y auto-scaling escala, sin importar quién generó la carga.
4. La paradoja de la indexabilidad
El problema adquiere su dimensión más difícil en sistemas cuyo contenido depende de ser accesible públicamente: catálogos, repositorios, plataformas de ecommerce con productos indexados, bases de conocimiento abiertas. En estos casos, la indexabilidad por parte de los crawlers de IA no es optativa sino constitutiva del valor del sistema.
Wix reportó en junio de 2026 que las plataformas de IA ya generaban tráfico de referencia hacia cerca de 700,000 de sus sitios cada mes, con 2.2 millones de sesiones solo en marzo, aunque ese tráfico seguía representando menos del 1% del total de visitas a esos sitios . Cloudflare reporta que menos del 1% de los sitios en su red bloquea los bots de búsqueda de IA, frente a un 17% que ya restringe el tráfico de entrenamiento . Esa asimetría es consistente con una lectura operacional: el costo de la invisibilidad en el ecosistema de IA supera, para la mayoría de los operadores, el costo de la carga de infraestructura.
La paradoja se puede expresar de forma directa: bloquear el crawler resuelve el problema de capacidad a expensas de la visibilidad; permitirlo mantiene la visibilidad a expensas de la capacidad. La arquitectura de AWS ofrece una salida parcial a esta tensión mediante la combinación de WAF, CloudFront y CloudFront Functions, pero requiere implementación explícita. No existe una configuración nativa que lo resuelva de forma automática. AWS ha reconocido parcialmente esta brecha con el lanzamiento de AI Traffic Monetization en junio de 2026 y con los dashboards de tráfico de IA para WAF, aunque ninguno de esos mecanismos resuelve la priorización de cómputo entre usuarios y bots.
Un segundo efecto agrava la situación. Cuando se intenta controlar el tráfico de bots endureciendo las reglas de WAF (por ejemplo, activando la regla NoUserAgent_HEADER del Common Rule Set para bloquear requests sin User-Agent), se corre el riesgo de afectar integraciones legítimas. Las APIs server-to-server, los webhooks de pasarelas de pago y los callbacks de servicios externos frecuentemente omiten el header User-Agent, un comportamiento protocolariamente correcto que esa regla penaliza. En el entorno analizado, al pasar esa regla de COUNT a BLOCK, se bloquearon los webhooks de una pasarela de pago durante cuatro minutos. La documentación de AWS advierte que cambios en patrones de tráfico pueden aumentar la tasa de falsos positivos incluso en reglas con historial de baja incidencia .
5. Por qué algunos sistemas sienten el impacto más que otros
No todos los sistemas son igualmente susceptibles. La magnitud del impacto de un AI crawler sobre un servidor depende en buena medida de las características arquitectónicas de la aplicación, no solo de su popularidad.
Un blog estático y un sistema de recuperación de información con búsqueda facetada pueden tener volúmenes de tráfico humano similares, pero el costo computacional de cada solicitud de un crawler es radicalmente diferente entre ambos.
Cuando el bot accede a una página estática:
NONE
GET /post/aws-architecture HTTP/1.1
El servidor devuelve un archivo HTML. CloudFront puede servir esa respuesta desde caché indefinidamente: el origen no recibe el request.
Cuando accede a un sistema con búsqueda facetada:
NONE
GET /search?idx=subject&q=16924
&filter=branch:BRANCH-02
&filter=collection:Adult
&sort_by=relevance&count=20
El servidor ejecuta una consulta contra la base de datos con joins, filtros combinados, ordenamiento y paginación. El costo computacional es equivalente al de una búsqueda ejecutada por un usuario real.
5.1 Por qué el tipo de arquitectura importa
La observación de campo lleva a una pregunta directa: ¿todos los sistemas sienten el mismo nivel de impacto de un AI crawler, o hay algo en el diseño de ciertos sistemas que los hace más vulnerables?
La evidencia disponible apunta hacia el segundo caso. No es que los sistemas de búsqueda facetada sean más populares o tengan más contenido. Es que el costo computacional de cada solicitud del bot es estructuralmente diferente: cuando el agente llega a un sistema con búsqueda por filtros combinados, cada request obliga al servidor a ejecutar una consulta real contra la base de datos. No hay forma de responder desde memoria o desde un archivo ya generado.
Esta observación es consistente con evidencia documentada de forma independiente, antes de la publicación de este análisis: COAR (2025) reportó acceso de bots las 24 horas en sus repositorios de acceso abierto , Library Journal (2025) documentó caídas e interrupciones específicamente en sistemas de este tipo , y el proyecto DSpace tiene un issue activo desde 2025 donde sus usuarios documentan que, al intentar bloquear bots agresivos, terminan bloqueando accidentalmente a Google Scholar . Esa observación ilustra el problema: el diseño del sistema dificulta distinguir un crawler legítimo de uno que satura, porque ambos consultan el mismo endpoint con los mismos parámetros.
Lo que este análisis agrega es una explicación técnica de por qué ocurre, y una clasificación provisional de qué tipos de arquitectura tienen mayor probabilidad de experimentarlo. Esa clasificación no está validada con mediciones comparadas entre tipos: es un marco para orientar el diagnóstico, no una taxonomía empírica, y queda abierta a revisión con datos adicionales.
5.2 Factores propuestos como amplificadores
Se proponen cuatro factores que, en combinación, amplificarían la vulnerabilidad. Los factores 1 y 4 están documentados directamente en los logs; los factores 2 y 3 se derivan del análisis técnico de la arquitectura.
Factor 1. Búsqueda facetada con parámetros en la URL
Cada combinación de filtros genera una URL única que activa una consulta independiente contra la base de datos. En los logs analizados, las solicitudes del agente incluían hasta seis parámetros de filtrado simultáneos: categoría temática, autoría, colección, sucursal, disponibilidad y serie documental.
Factor 2. Espacio combinatorio de URLs
Con cuatro o más dimensiones de filtrado independientes, el número de combinaciones válidas crece factorialmente. Una estrategia de caché basada en URL completa tiene una tasa de aciertos estructuralmente baja ante ese espacio de variación.
Factor 3. Ausencia de Cache-Control apropiado para contenido de búsqueda (análisis técnico)
Si la aplicación no emite headers Cache-Control con TTL positivo para sus resultados de búsqueda, CloudFront trata ese contenido como dinámico no cacheable y pasa cada solicitud al origen. En sistemas que priorizan la actualización inmediata del catálogo, esta es la configuración habitual.
Factor 4. Endpoints de descubrimiento automático (observado en logs)
El agente consultaba feeds RSS y descriptores OpenSearch expuestos por la aplicación:
NONE
GET /search?…&format=opensearchdescription
GET /search?…&format=rss
Un feed RSS de una búsqueda devuelve un listado de registros con sus URLs, lo que multiplica la superficie de rastreo a partir de un número reducido de solicitudes iniciales.
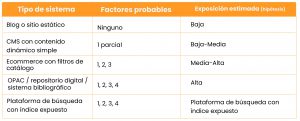
5.3 Marco analítico provisional por tipo de sistema
La tabla siguiente es una hipótesis de trabajo, no una taxonomía empírica. El único tipo con evidencia directa de logs en este análisis es el de sistemas de recuperación de información; la extrapolación a los demás tipos es analítica y se ofrece como punto de partida para discusión, no como conclusión cerrada.
6. AWS WAF bajo la lupa: una revisión mecanismo por mecanismo
Esta sección examina AWS WAF desde cada ángulo relevante para el problema: dónde se posiciona en la red, cómo evalúa cada solicitud, qué puede detectar, qué acciones tiene disponibles contra un bot ya identificado, y dónde termina su alcance. El objetivo no es describir WAF en general, sino recorrer mecanismo por mecanismo (posición en la red, pipeline de evaluación, Bot Control, rate limiting, las funciones más recientes) para precisar, en cada uno, qué resuelve y qué no. La brecha que aparece al final no es un defecto de configuración: es un límite del paradigma bajo el cual la herramienta fue diseñada, y solo se vuelve visible al revisarla pieza por pieza.
6.1 La posición de WAF en la pila de red
AWS WAF no es un servidor independiente sino un motor de evaluación de reglas que se inserta como capa de inspección entre internet y el recurso protegido. Los recursos que puede proteger son: Application Load Balancer (ALB), distribuciones de Amazon CloudFront, Amazon API Gateway, AWS AppSync, Amazon Cognito user pools, AWS App Runner y AWS Verified Access.
El scope de asociación determina dónde en la red actúa la inspección: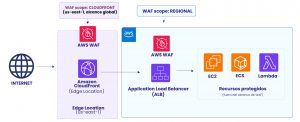
Un WAF REGIONAL asociado a un ALB no inspecciona la solicitud hasta que esta ya cruzó internet y llegó a la región AWS. En el momento del bloqueo, el ancho de banda entrante ya fue consumido. Un WAF CLOUDFRONT actúa en el edge, antes de que la solicitud atraviese hacia la región, lo que lo hace más eficiente para el problema de AI crawlers.
6.2 El motor de evaluación: pipeline de procesamiento
Cada solicitud que llega al recurso protegido se somete al siguiente pipeline de evaluación secuencial:
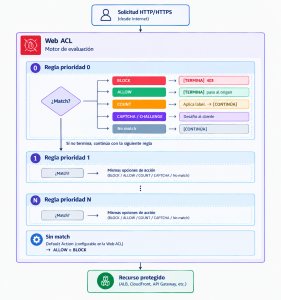
BLOCK y ALLOW son acciones terminantes: detienen la evaluación inmediatamente. Si la regla de prioridad 0 hace match con BLOCK, las reglas 1, 2, 3… nunca se evalúan. COUNT es no terminante: registra el match, aplica etiquetas (labels) a la solicitud y continúa evaluando el resto del Web ACL.
Los labels son el mecanismo de comunicación entre reglas. Una regla puede etiquetar una solicitud sin bloquearla, y reglas posteriores pueden condicionar su comportamiento según esos labels:
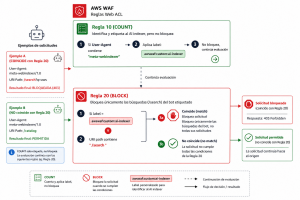
Este patrón label-acción condicional es la base para cualquier control sofisticado de AI crawlers dentro de WAF.
6.3 Los componentes inspeccionables de cada solicitud
WAF tiene acceso a los siguientes elementos de la solicitud HTTP/HTTPS para definir condiciones de match:
